smilespark.github.io
yukuoyuan的数据分析项目成果
项目成果:泰坦尼克号生存预测
关键词
数据分析流程,经典模型,性能测评,解释模型
项目背景
通过多角度分析确定特征变量,使用sklearn机器学习包,调用经典模型,对幸存率进行预测,最终给出模型解释。
获得技能
最常用的特征分析方法,调用经典模型,性能评价,通过决策树解释模型。
以下是报告正文
一、提出问题
- 哪些单一特征群体的幸存率较大?
- 怎样的复合特征群体的幸存率较大?
- 最终选择的特征间如果存在较大相关性,是否会降低预测准确率?
二、数据加工
导入库,查看字段,查看数据统计信息
完整性
应fillna的字段:age,cabin(较多),embarked,fare
有效性
应drop的字段:passengerid,name,ticket,cabin缺乏有效信息
合并、分解特征
- sibsp+parch–>family
- name–>title
- age–>age_bands
- fare–>fare_ranges
经验假设
女性、孩子、高等舱的幸存率更高
三、数据探索
特征:Sex,Age
Observations
- 人数最多:15-35岁
- 幸存率高:婴儿(0-4岁),老年人(80岁)
- 幸存率低:15-25岁
特征:Pclass,Pclass&Age
Observations
- 人数最多:pclass=3
- 幸存率高:pclass=1,婴儿(pclass=1,2)
- 幸存率低:pclass=3
Decisions
特征选择:pclass=3的幸存率区分度大
特征:Embarked
Observations
- 幸存率高:女性,男性(embarked=C)
Decisions
特征选择:sex、embarked=C的幸存率区分度大
特征:Fare
Observations
- 幸存率高
- 女性:S、C,且(平均)票价高
- 男性:C,且(平均)票价高
Decisions
特征选择:划分票价区间
四、数据再加工
- 修复完整性和无效性
- 特征转换:将类别转换为数字:Sex,Embarked
- 查看相关性:相关系数矩阵
- 特征转换:划分数值区间(分箱):Age,Fare
- 特征转换:从文本中截取关键字:Name
特征:Name
Observations
- 仅Mr、Miss、Mrs的样本容量充分
- Mr、Miss同向,Mr则相反
Decisions
将Miss、Mrs分为一组,其它分为另一组。
特征:sibsp+parch–>family
Observations
- family、sibsp、parch的集中趋势是相似的,family对区分度没有更多帮助
Decisions
不对sibsp、parch进行合并
五、调用机器学习模型
训练模型,性能测评,模型排名
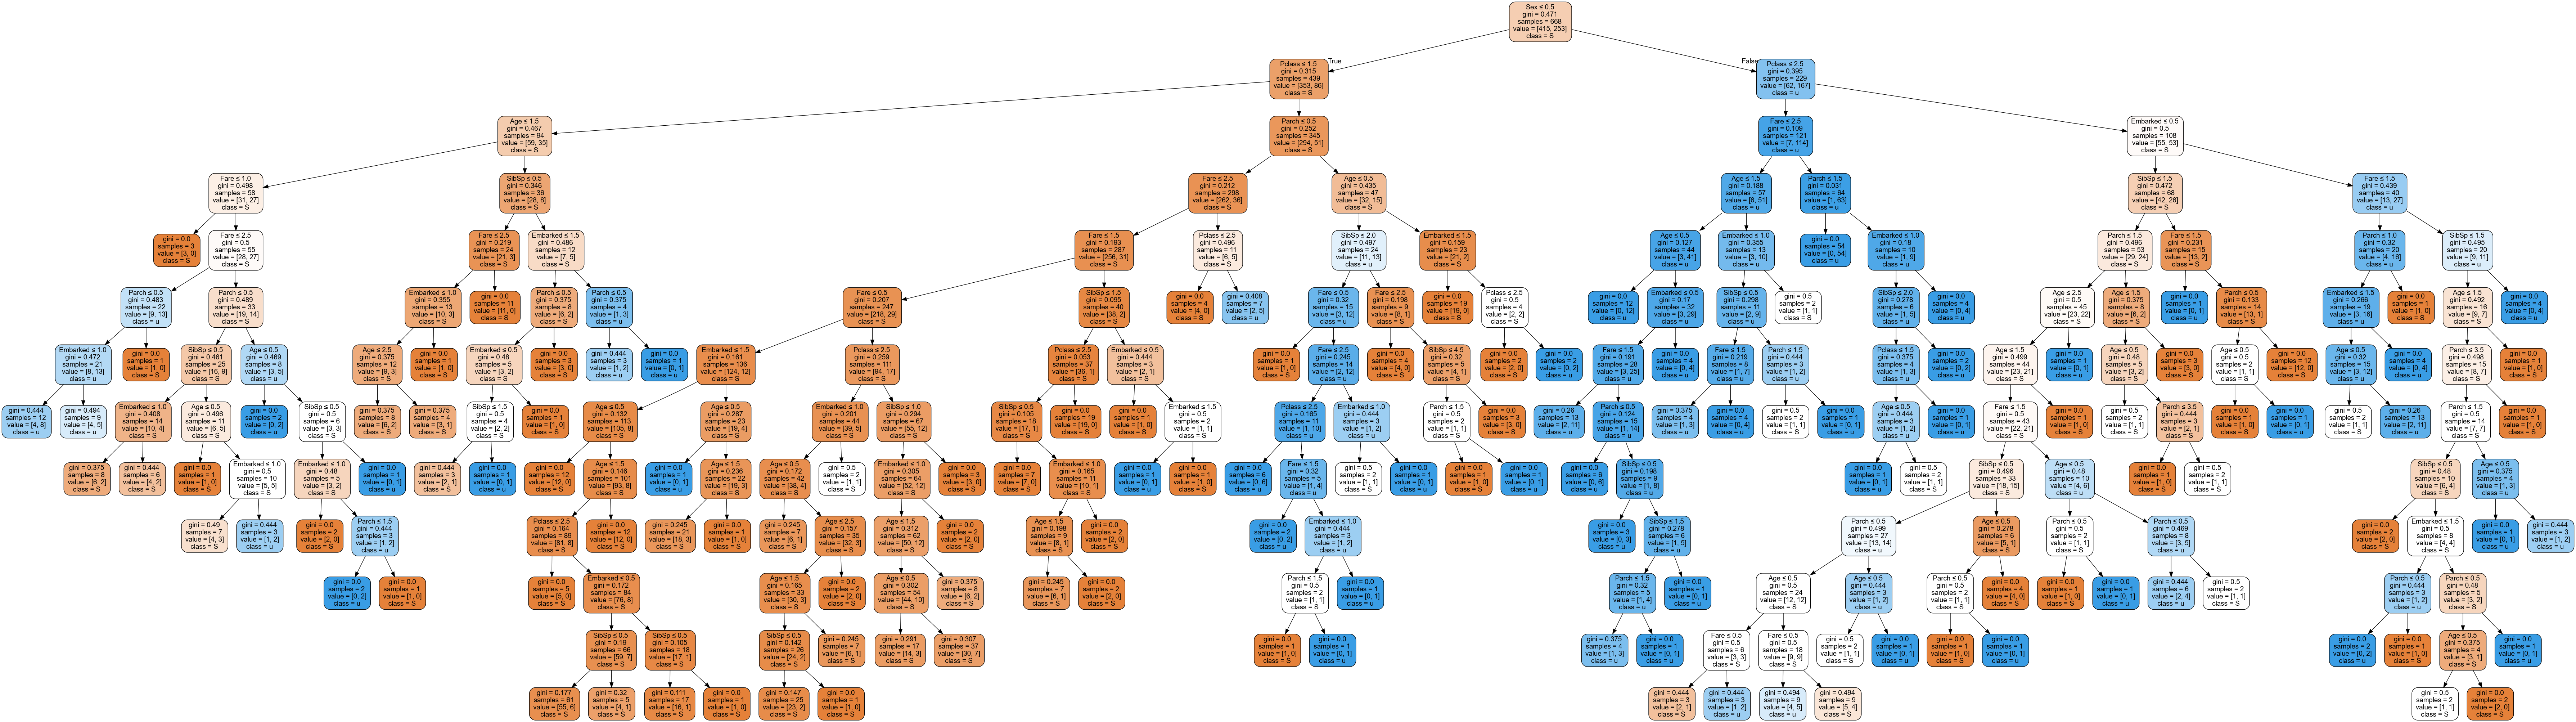
模型可视化:以决策树为例
六、结论
背景分析
- 本次目标属于分类问题,一般会选择监督学习中分类学习模型。
- 数据量未达到10万,因此暂不考虑模型效率问题。
特征分析
- 特征选择:Age Embarked Fare Parch PassengerId Pclass Sex SibSp Title
- 处理方式:对于每个特征,通过聚合数据,观察其与标签(幸存率)的关系,从而划分出级别,并用序数标记。最终都被整理为了离散值。
- 备选方式:抽了逐一手动处理特征,还可以考虑保留连续性变量,或调用特征向量化方法进行自动处理;但经过比较,发现逐一分析变量,手动聚合为离散值的方式,效果较好。
- 经验:
- 增加无关特征,准确率降低
- 增加特征title后,准确率
- 提高的:梯度上升决策树(+0.004),决策树(+0.004)
- 下降的:梯度下降(-0.09)
- 不变的:支持向量机,逻辑回归,随机森林,k邻近法(最优n由6变为11)
模型评价
准确率
- 参数模型:
- 最高,集合模型:梯度上升决策树;
- 其次,支持向量机,逻辑回归;
- 然后,随机森林,决策树;
- 最后,梯度下降。
- 非参数模型:当n取11时,准确率最高,且排名第二。
模型解释
- 相关系数矩阵:相关性较强的原始特征为sex、pclass、fare
- 决策树可视化:sex、pclass是最重要的特征,值得关注的人群有
- 对于男性:1等舱,20岁以上的,幸存率较好
- 对于男性:2、3等舱、无亲属、低票价的,幸存率较好
- 对于男性低龄儿童:2、3等舱、无亲属的,幸存率较差
- 对于男性低龄儿童:2、3等舱、既有直系亲属又有旁系亲属,幸存率较好
- 对于女性:1、2等舱的,生存率较差
- 对于女性:3等仓,上传地点为S,亲属较多的,幸存率较好
- 对于女性:3等仓,上传地点为S,低龄的,幸存率较好